Tre KI-agenter, én blogg
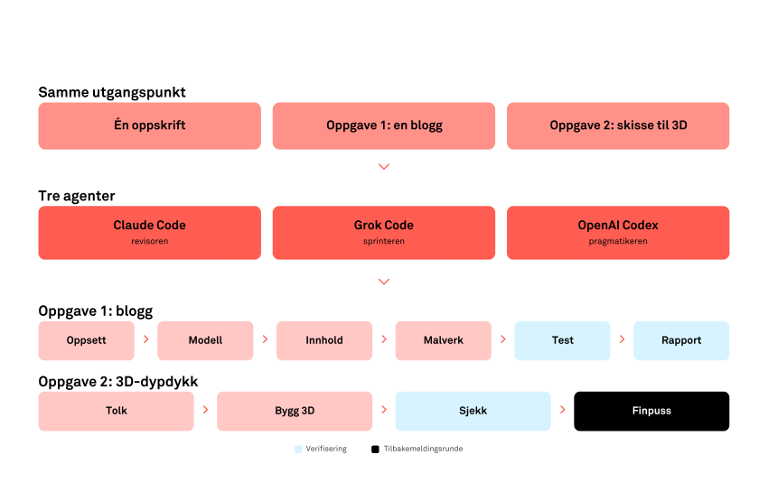
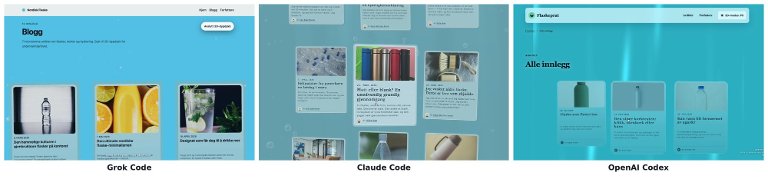
Vi ga Claude Code, Grok Code og OpenAI Codex samme oppgave: Bygg en komplett blogg fra bunnen av. Alle tre kom i mål, men det mest interessante skjedde etter at koden var skrevet.
Written by Morten Eriksen on
Vi ga Claude Code, Grok Code og OpenAI Codex nøyaktig samme utgangspunkt: en tom mappe, de samme instruksjonene og målet om å bygge en komplett CMS-blogg med frontend, innhold og design. Så skrudde vi opp vanskelighetsgraden med en interaktiv 3D-oppgave. Alle tre kom i mål, men de jobbet ganske forskjellig underveis. De tydeligste forskjellene viste seg først etter at den første versjonen var levert.
Vi ville teste noe mer realistisk enn en todo-app
Det finnes allerede mange sammenligninger av KI-agenter, men de handler ofte om avgrensede oppgaver: et lite spill, en enkel app eller noen hundre linjer kode.
Det sier lite om hvordan agentene fungerer når de møter noe som ligner faktisk produktarbeid. En moderne nettløsning innebærer mer enn kode. Den kan kreve innholdsmodellering, API-er, frontend, design, bilder og rettigheter, tilgjengelighet, sikkerhet og redaksjonelle arbeidsflyter. Og til slutt må noen kontrollere at det som er bygget faktisk fungerer.
Derfor ga vi alle tre agentene samme utgangspunkt: å bygge en komplett CMS-basert blogg på Enonic XP 8 med Next.js som frontend. Ingen mennesker skrev kode underveis.
For å gjøre testen så sammenlignbar som mulig fikk agentene de samme instruksjonene. De lå i én markdown-fil uten ferdig kode og beskrev først og fremst hvordan agentene skulle arbeide: hvordan løsningen skulle settes opp, hva som måtte kontrolleres underveis og hvilke kriterier som måtte være oppfylt før oppgaven kunne regnes som ferdig.
De ble blant annet bedt om å teste løsningen i en ekte nettleser, kontrollere mobil og desktop, sjekke lys og mørk modus, validere tilgjengelighet og dokumentere det de ikke kunne verifisere.
Dette er ikke et vitenskapelig benchmark. Hver agent ble kjørt én gang, på samme maskin og fra samme startpunkt. Modellene og verktøyene utvikler seg også raskt. Resultatene bør derfor leses som et øyeblikksbilde av hvordan de tre agentene løste denne typen oppgave.
Oppgave 1: Bygg en komplett blogg
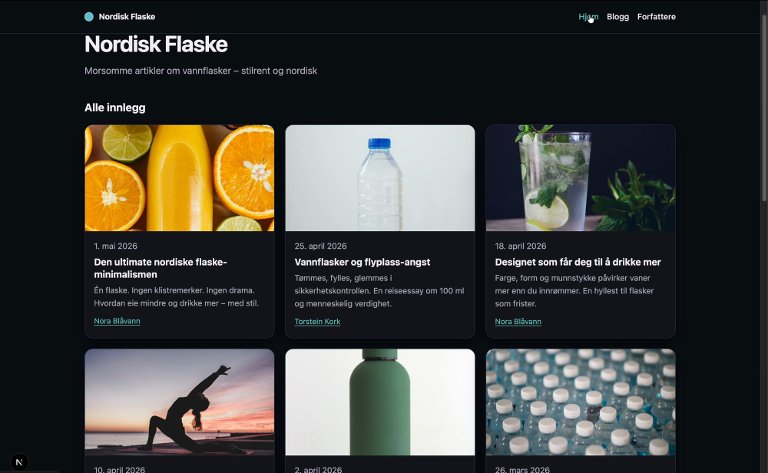
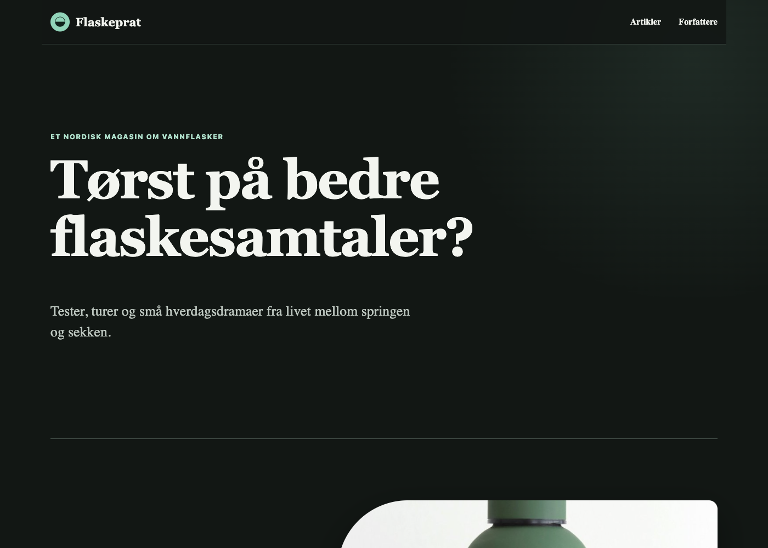
Første oppgave var en norsk blogg om vannflasker. Agentene skulle lage ti publiserte artikler, tre fiktive forfattere med KI-genererte portretter, coverbilder med dokumenterte bruksrettigheter, design basert på Designsystemet.no, lys og mørk modus, WCAG 2.2 AA og en fungerende redaksjonell arbeidsflyt i Content Studio.
Alt skulle bygges fra en tom mappe.
| Grok Code | Claude Code | OpenAI Codex | |
|---|---|---|---|
| Modell | Grok 4.5 | Opus 5 | GTP-5.6 Sol |
| Tid | ca. 22 min | 62 min | 64 min |
| Resultat | Komplett blogg | Komplett blogg | Komplett blogg |
| WCAG-feil | 0 | 0 | 0 |
| Oppfølging etter "ferdig" | Ja | Nei | Mindre justering |
Grok Code var klart raskest. Rundt 22 minutter fra tom mappe til publisert og testet blogg er imponerende. Men etter at agenten hadde meldt at jobben var ferdig, viste det seg at forhåndsvisningen i den redaksjonelle løsningen ikke fungerte. To problemer måtte rettes før løsningen faktisk var klar.
Det illustrerte noe som skulle gå igjen gjennom hele testen: Tid til første resultat og tid til et resultat du faktisk kan overlevere, er ikke nødvendigvis det samme.
Claude Code brukte 62 minutter og var den grundigste av de tre. Det mest interessante var ikke bare hvor mange tester den kjørte, men hva den valgte å kontrollere. Da den hentet bilder til bloggen, åpnet den kandidatene i full størrelse og forkastet ti bilder, blant annet fordi logoer og merkevarer som knapt var synlige i forhåndsvisningen ble tydelige i full oppløsning.
Claude dokumenterte også potensielle feil den eksplisitt hadde sett etter, selv når de ikke hadde oppstått. Da agenten meldte at den var ferdig, fant vi ikke noe som krevde en ny runde.
OpenAI Codex brukte 64 minutter og traff godt på balansen mellom fremdrift og grundighet. Den gjennomførte blant annet en sikkerhetsgjennomgang som endte med null kjente npm-sårbarheter, uten å tvinge gjennom oppgraderinger som kunne skape breaking changes.
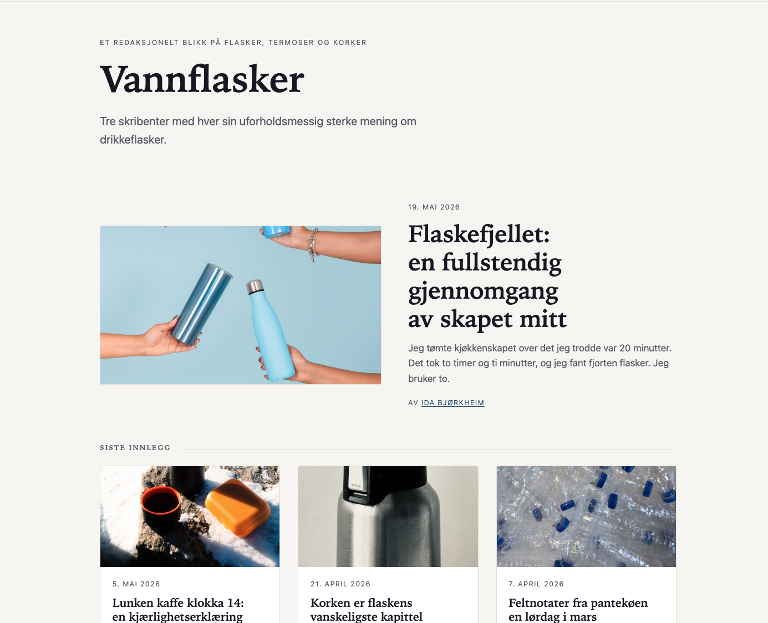
Codex håndterte også endringer underveis godt. Da informasjonen om en av de fiktive forfatterne ble korrigert to ganger, regenererte agenten portrettet, oppdaterte innholdet og kjørte kontrollene på nytt uten å miste oversikten over resten av prosessen. Visuelt var dette også løsningen vi syntes hadde den tydeligste identiteten. Codex tok dessuten vannflasker med en imponerende grad av alvor, og leverte blant annet "En kjærlighetserklæring til vannflasken".x
Det er likevel litt misvisende å kalle dette en ren kodetest. På under 65 minutter skrev hver agent ti norske artikler, laget forfatterprofiler, genererte portretter, fant og vurderte bilder, skrev alt-tekster, dokumenterte rettigheter, bygget frontend, testet løsningen i nettleser og kontrollerte tilgjengelighet.
Dette er oppgaver som normalt ville vært fordelt mellom flere fagområder. I Claude Codes kjøring gikk dessuten bare en del av tiden til det vi tradisjonelt ville kalt programmering. Bildearbeid og verifisering tok nesten like mye tid som frontend-utviklingen.
Det sier noe om hvor lite nyttig det er å vurdere KI-agenter utelukkende etter hvor raskt de produserer kode.
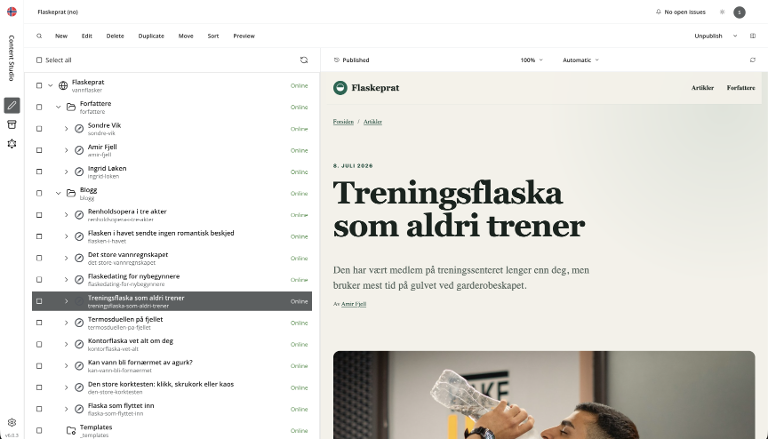
Hvordan ser dette ut i Content Studio?
Alle tre agentene satte opp Enonic med egne innholdstyper for forfattere og blogginnlegg.
Blogginnleggene fikk blant annet felter for tittel, ingress, forfatter, emner og brødtekst. Bilder ble hentet fra Unsplash til blogginnleggene, mens forfatterbildene ble AI-generert. Bildene ble lagret sammen med innholdet i strukturen.
Agentene opprettet også sidemaler for forside, bloggliste, bloggvisning, forfatterliste og forfattervisning, med forhåndsvisning mot front-end i Next.js.
Selve innholdet varierte også mellom agentene. Codex skilte seg blant annet ut med en litt vittigere skrivestil enn de andre.
Oppgave 2: Fra skisse til 3D-opplevelse
Så gjorde vi oppgaven vanskeligere.
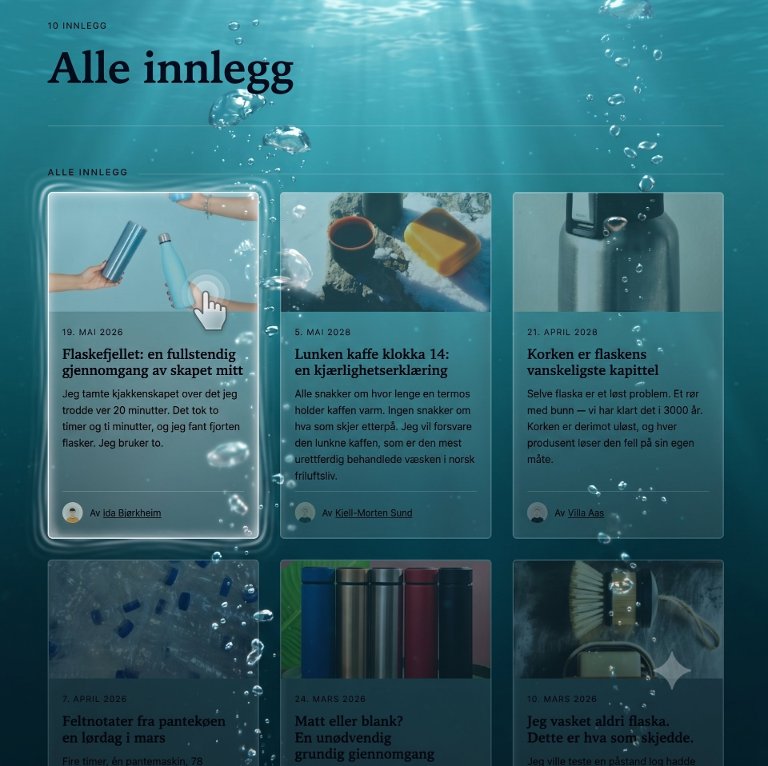
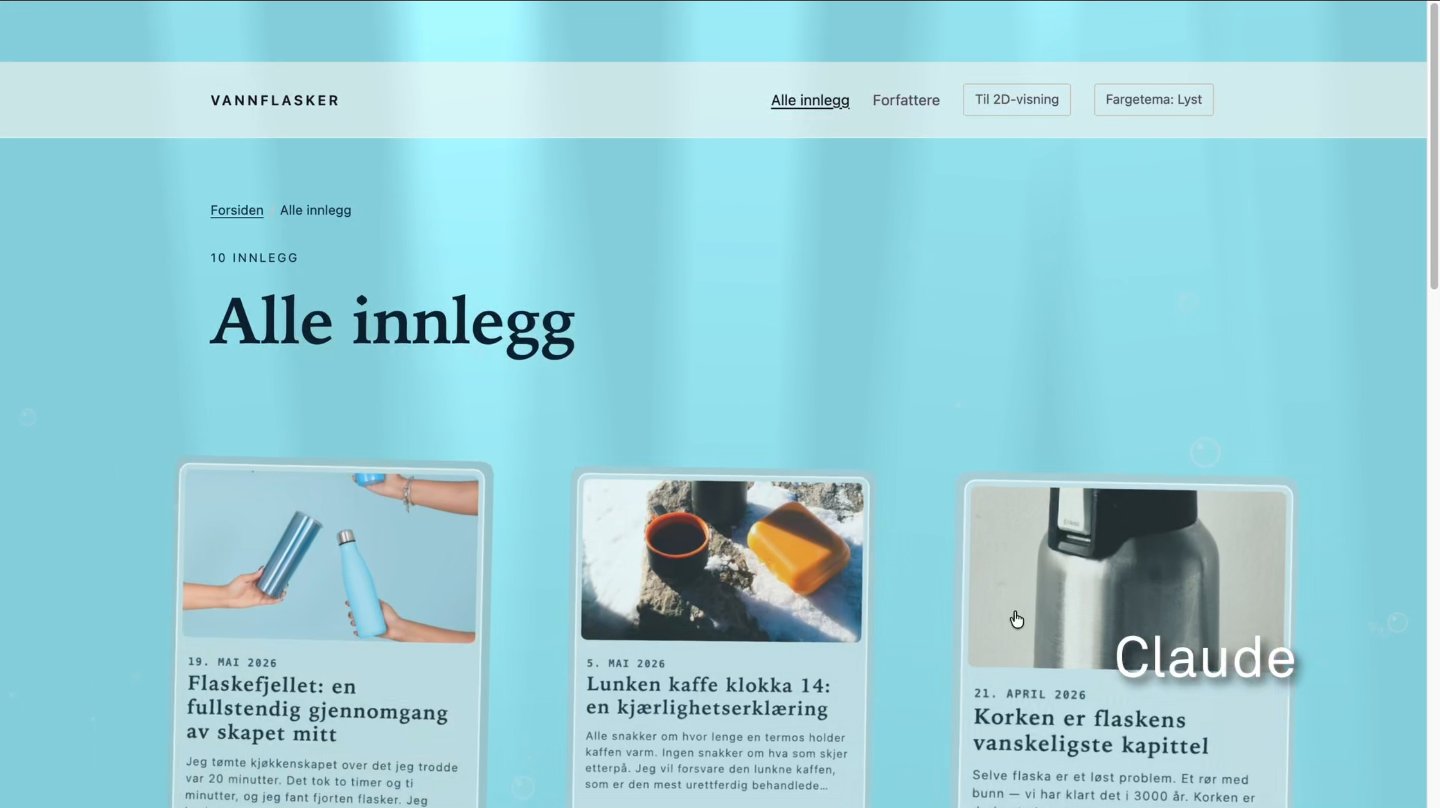
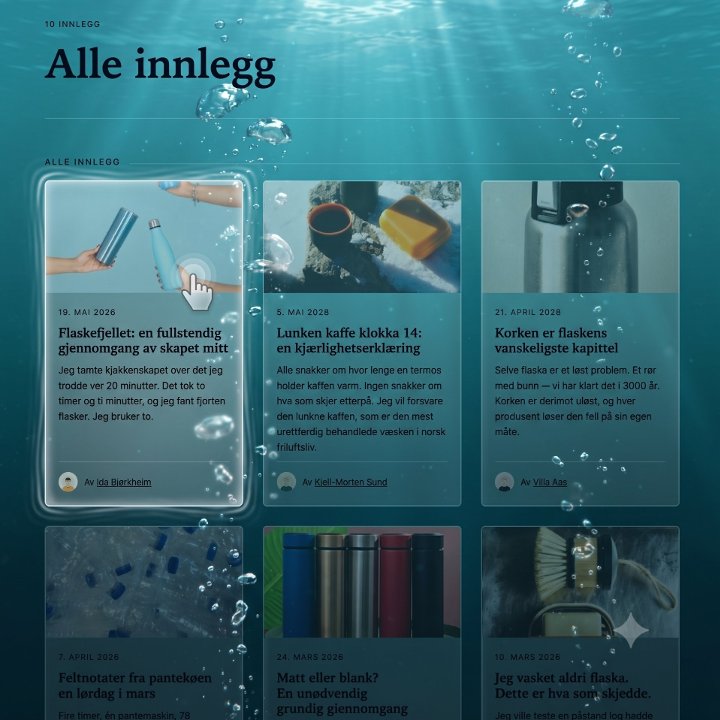
Alle tre fikk den samme skissen (laget i Google Gemini) og en tekstlig beskrivelse av en undervannsopplevelse for bloggarkivet. Artiklene skulle sveve som frostede glasskort under vann, kameraet skulle bevege seg dypere når brukeren scrollet, og løsningen skulle ha bobler, lyseffekter og interaksjon.
Denne gangen fantes det ikke bare ett riktig svar. Agentene måtte tolke en intensjon.
Codex var raskest til et resultat vi faktisk syntes var godt. Etter omtrent 26 minutter hadde den en fungerende og gjennomarbeidet versjon. Underveis valgte den også å avvike fra spesifikasjonen: Glasskortene skulle slippe gjennom 95 prosent av lyset, men Codex reduserte dette til 55 prosent fordi teksten ellers ble vanskelig å lese.
Det interessante var at agenten både tok avgjørelsen og dokumenterte hvorfor. Den fulgte altså ikke bare instruksjonen bokstavelig, men gjorde en vurdering og gjorde avviket synlig.
Claude Code brukte 64 minutter og fant flere problemer som ikke ga klassiske feilmeldinger. Blant annet oppdaget den en browser-API-feil som slo ut deler av 3D-stylingen, en stacking-feil som skjulte sidetittelen og et kontrastproblem som bare oppstod med bestemte verdier lagret i nettleseren.
Testene så i utgangspunktet grønne ut. Feilene ble funnet fordi agenten gikk lenger enn selve testresultatet.
Grok Code fikk raskt frem en fungerende scene, men veien fra fungerende til gjennomarbeidet krevde mest menneskelig oppfølging. Boblene var først firkantede, kortene overlappet og scenen brukte bare deler av skjermbredden. Problemene ble rettet, men underveis forsvant også lenker for tastaturnavigasjon og skjermlesere uten at agenten varslet om det.
3D-oppgaven viste dessuten at agentene må kunne stille spørsmål ved måleverktøyene sine. De første ytelsestestene viste bare 4–7 bilder i sekundet, langt under målet. To av agentene undersøkte målingen før de begynte å optimalisere og oppdaget at den hodeløse nettleseren rendret grafikken i software i stedet for på GPU. På en faktisk GPU kjørte den samme løsningen i 120 FPS.
En grønn test kan være feil. Det kan en rød test også.
Slik skilte agentene seg i denne testen
Etter begge oppgavene tegnet det seg tre tydelige arbeidsstiler.
| Grok Code | Claude Code | OpenAI Codex | |
|---|---|---|---|
| Raskest til første oppgave | ⭐⭐⭐ | ⭐☆☆ | ⭐☆☆ |
| Raskest på andre oppgave | ⭐☆☆ | ⭐☆☆ | ⭐⭐⭐ |
| Selvstendighet | ⭐☆☆ | ⭐⭐⭐ | ⭐⭐⭐ |
| Kontroll etter første resultat | ⭐⭐☆ | ⭐⭐☆ | ⭐⭐⭐ |
| Tolkning av design og brief | ⭐☆☆ | ⭐☆☆ | ⭐⭐☆ |
Poengkortet oppsummerer det vi observerte i disse kjøringene. Det er ikke ment som en generell rangering av modellene.
Grok var sprinteren: Raskest til første resultat, men med størst behov for menneskelig oppfølging.
Claude var revisoren: Langsommere, men konsekvent grundig og med minst behov for oppfølging etter at jobben var meldt ferdig.
Codex var pragmatikeren: I denne testen traff den best på kombinasjonen av fart, selvstendighet, visuell kvalitet og evnen til å ta gode valg underveis.
Hvis vi måtte velge én vinner fra akkurat disse kjøringene, ville det vært Codex. Men det er ikke den viktigste konklusjonen.
Det viktigste skjer etter at koden er skrevet
Modellene vil endre seg, og en ny versjon kan raskt snu rangeringen. Det som er mer interessant, er forskjellene i hvordan agentene jobber.
Alle tre kunne bygge. De største forskjellene lå i hvordan de kontrollerte sitt eget arbeid: Om de faktisk så på resultatet, testet ulike skjermstørrelser, oppdaget misvisende målinger og dokumenterte det de ikke hadde klart å verifisere.
Derfor blir spørsmålet etter hvert mindre:
Hvor god er KI-agenten til å skrive kode?
Men mer:
Hvor god er den til å finne ut om det den har laget faktisk fungerer?
De felles instruksjonene viste seg også å være viktige. De beskrev i liten grad hvilken kode agentene skulle skrive, og i større grad hvordan de skulle arbeide: hva som måtte kontrolleres, hvilke signaler de ikke burde stole blindt på og hva som måtte være verifisert før jobben var ferdig.
De samme rammene ga tre ganske forskjellige agenter et høyt minimumsnivå. Det gjør gode arbeidsprosesser mer interessante enn enkeltprompter, fordi de kan følge med videre selv om modellen eller leverandøren byttes ut.
Et nytt krav til digitale plattformer?
Testen startet som en sammenligning av KI-agenter, men underveis dukket det opp et annet spørsmål:
Hvor lett er systemet agenten jobber med å forstå og kontrollere?
For å løse oppgaven måtte agentene kunne installere plattformen, modellere og publisere innhold, bruke API-er, bygge frontend og kontrollere både nettstedet og den redaksjonelle arbeidsflyten. Alt uten at et menneske måtte gjennomføre manuelle steg mellom operasjonene.
Det var mulig fordi Enonic XP har gjennomarbeidet dokumentasjon på utviklerportalen, CLI for å kjøre opp lokalt miljø, redaktørgrensesnitt som kan navigeres med KI, startpakke for Next.js, API-er og et rammeverk for å bygge tilpasninger. Det er ikke en egen KI-funksjon, men en konsekvens av hvordan plattformen er bygget.
Og det kan bli stadig viktigere.
Digitale plattformer vurderes i dag på blant annet redaktøropplevelse, fleksibilitet, sikkerhet, API-er og utvikleropplevelse. Kanskje kommer det snart et nytt spørsmål på den listen:
Kan en KI-agent faktisk jobbe selvstendig med plattformen?
Ikke bare generere kode ved siden av den, men installere den, forstå den, bruke den og kontrollere resultatet.
I denne testen klarte alle tre det.
Det betyr ikke at mennesker er ute av bildet. Eksperimentet viste snarere hvor menneskelig vurdering fortsatt betyr mest: smak, prioriteringer, risiko og spørsmålet om noe faktisk er godt, ikke bare teknisk korrekt.
Men arbeidsdelingen er i ferd med å endre seg.
Og etter testen sitter vi igjen med et litt annet spørsmål enn det vi startet med:
Hvordan bygger vi systemer og arbeidsprosesser der både mennesker og KI-agenter kan gjøre en god jobb?